Catatan Lapangan
Metadata 101: Kenalin Situsmu ke Web Biar Gak Salah Paham
Website-mu bisa aja ngebut dan cakep banget, tapi tetap gak ada yang nemuin. Hasil pencarian cuma nampilin cuplikan kosong, link yang dishare muncul sebagai URL polos tanpa gambar, dan crawler malah nge-index versi halaman yang salah. Itu semua bukan soal desain, bro. Itu soal metadata.
Beberapa waktu lalu aku bikin carousel singkat soal ini di LinkedIn. Nah, artikel ini versi panjangnya: metadata itu fungsinya apa aja, siapa yang baca, dan gimana cara pasangnya yang bener di Next.js App Router.
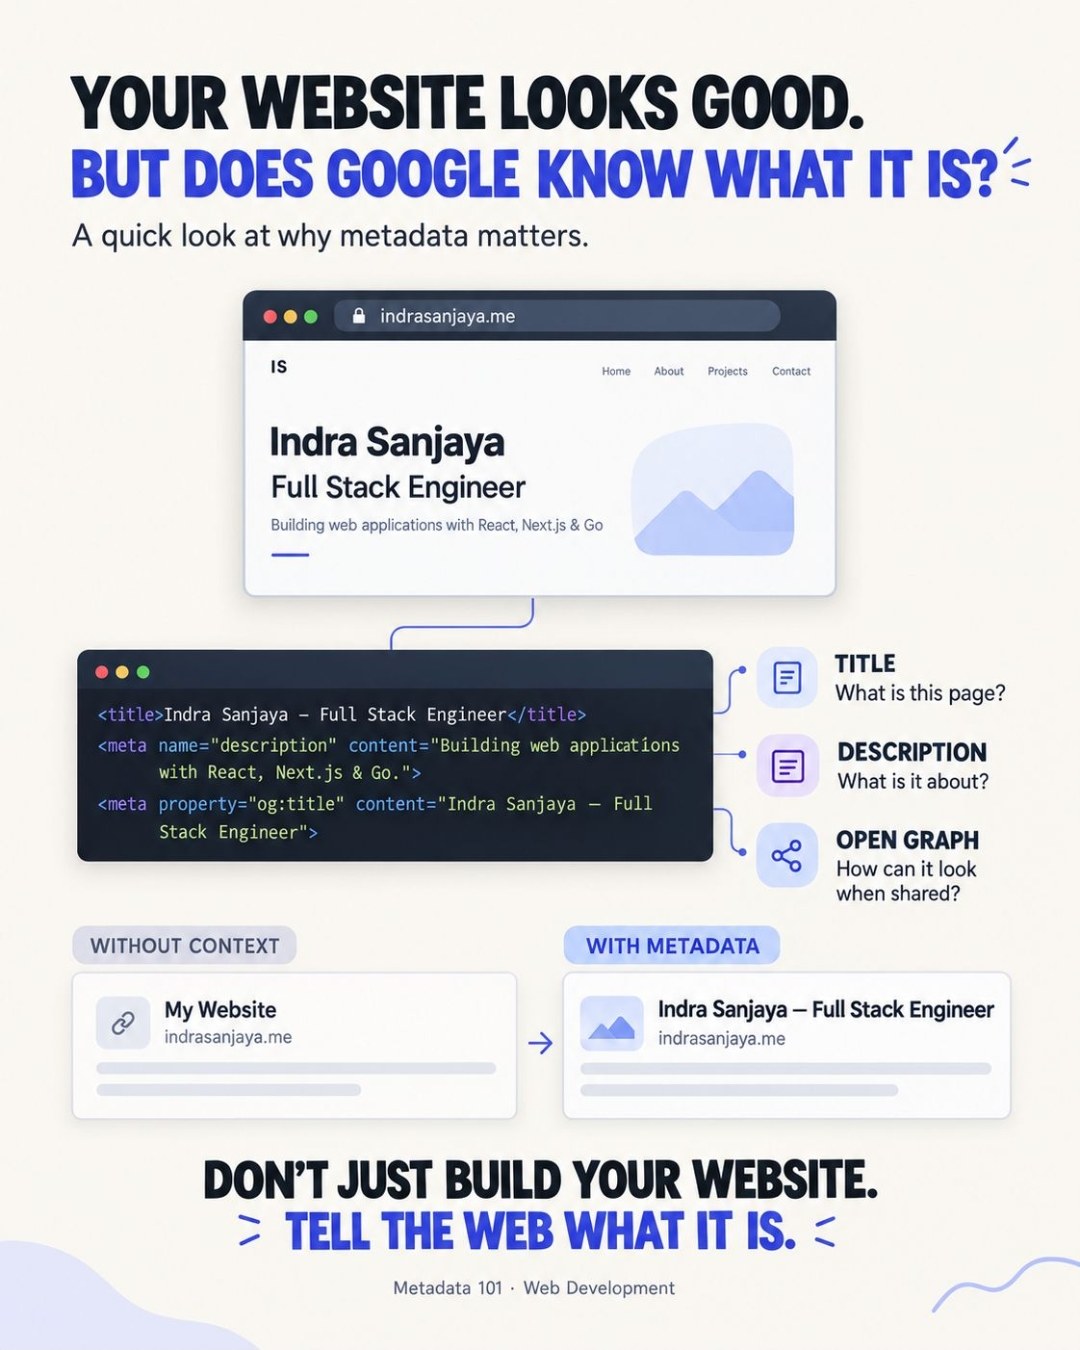
FIG. 01Satu Halaman, Tiga Penonton
Halamanmu dibaca tiga "penonton" yang beda banget, dan cuma satu yang punya mata.
- Manusia baca tampilan yang udah dirender: layout, tulisan, gambar.
- Search engine baca HTML-nya buat nentuin halaman ini bahas apa, isinya duplikat atau enggak, dan apa yang mau ditampilin di hasil pencarian.
- Crawler dan platform (LinkedIn, Slack, X, WhatsApp, Discord) ngambil halamanmu buat bikin preview link, dan biasanya mereka gak ngejalanin JavaScript-mu.
Metadata itu bagian halaman yang ditulis buat penonton nomor dua dan tiga. Letaknya di <head>, gak keliatan sama pengunjung, dan itu satu-satunya cara buat ngasih tau mesin halaman ini isinya apa, bukan dibiarin nebak-nebak sendiri.
Kalau kamu gak jelasin halamanmu ke mesin, mereka bakal jelasin sendiri, dan hasilnya jarang yang enak dilihat.
FIG. 02Tiap Sinyal Kerjanya di Mana
"Metadata" itu bukan satu mekanisme doang. Tiap sinyal kerja di tahap yang beda dalam perjalanan sebuah halaman, dan kebanyakan salah kaprah muncul gara-gara ketuker-tuker.
Sebuah halaman ditemukan (sitemap, link), di-crawl (diambil, tunduk sama robots.txt), diindeks (dipahami dan disimpan), terus akhirnya ditampilin (sebagai hasil pencarian atau preview link). Satu hal yang wajib kamu inget: robots.txt itu ngatur crawling, bukan pengindeksan. Kalau kamu blokir halaman di sana, crawler gak akan pernah liat tag noindex-nya, dan URL itu masih bisa muncul di hasil pencarian. Mau halaman gak masuk indeks? Izinin crawling, terus pakai noindex.
FIG. 03Lima Hal yang Wajib Ada
Title dan meta description
<title> itu judul hasil pencarianmu sekaligus nama tab browser. Bikin yang spesifik dan gak kepanjangan biar gak kepotong, kira-kira 50 sampai 60 karakter. Meta description itu pitch-mu di bawahnya. Dia gak langsung ngaruh ke peringkat, dan search engine boleh aja nulis ulang keduanya, tapi deskripsi yang jelas itulah yang bikin orang mau klik.
Oh ya, Google juga udah gak peduli sama tag lawas meta keywords. Skip aja.
Canonical URL
Konten yang sama sering nongol di beberapa alamat: pakai atau tanpa www, pakai parameter tracking, pakai atau tanpa garis miring di ujung. Canonical URL ngasih tau search engine mana yang jadi versi utama, jadi sinyalnya numpuk jadi satu, bukan kepecah-pecah. Ini sifatnya petunjuk, bukan perintah, dan harus diatur per halaman. Canonical yang cuma diset sekali di layout bakal ngarahin semua halaman ke URL yang sama, dan itu lebih parah daripada gak punya canonical sama sekali.
Open Graph dan Twitter Cards
Tag Open Graph (og:title, og:description, og:image, og:url) yang ngatur apa yang muncul waktu link-mu dishare. Pakai URL gambar absolut dengan ukuran sekitar 1200×630. Platform nge-cache preview dengan rajin banget, jadi abis ngubah tag, scrape ulang URL-nya lewat debugger platform (LinkedIn Post Inspector, Facebook Sharing Debugger).
Structured data
Structured data, idealnya pakai JSON-LD, ngejelasin entitas secara gamblang: halaman ini adalah sebuah Article, ditulis sama Person ini, terbit di tanggal ini. Ini bantu search engine ngerti halamanmu dan bisa bikin halaman layak dapet rich result, walaupun gak ada jaminan.
FIG. 04Cara Pasangnya di Next.js
App Router udah punya Metadata API bawaan, jadi semua ini gak perlu nulis tag <head> manual. Mulai dari default satu situs di root layout:
import type { Metadata } from "next";

export const metadata: Metadata = {
  metadataBase: new URL("https://example.com"),
  title: {
    default: "Your Name — Software Engineer",
    template: "%s | Your Name",
  },
  description: "One clear sentence about who you are and what you build.",
  openGraph: {
    type: "website",
    siteName: "Your Name",
    images: ["/og-image.png"],
  },
  twitter: { card: "summary_large_image" },
};
metadataBase bikin kamu bisa pakai path relatif di tempat lain; Next.js yang bakal ngubahnya jadi URL absolut, yang emang dibutuhin crawler sosial. Abis itu timpa per halaman pakai generateMetadata, sekalian sama canonical-nya:
import type { Metadata } from "next";

export async function generateMetadata({
  params,
}: {
  params: Promise<{ slug: string }>;
}): Promise<Metadata> {
  const { slug } = await params;
  const post = await getPost(slug);

  return {
    title: post.title,
    description: post.description,
    alternates: { canonical: `/articles/${slug}` },
    openGraph: {
      type: "article",
      title: post.title,
      description: post.description,
      publishedTime: post.publishedAt,
      images: [post.ogImage ?? "/og-image.png"],
    },
  };
}
Satu jebakan nih: field metadata yang bersarang digabungnya shallow. Kalau satu halaman definisiin openGraph, seluruh objek openGraph dari layout langsung ketimpa, jadi tulis ulang field (kayak siteName) yang masih kamu mau.
Tambahin structured data sebagai script JSON-LD, dengan < di-escape biar kontennya gak bisa nyelonong keluar dari tag:
const jsonLd = {
  "@context": "https://schema.org",
  "@type": "Article",
  headline: post.title,
  description: post.description,
  datePublished: post.publishedAt,
  author: { "@type": "Person", name: "Your Name" },
};

export default function Page() {
  return (
    <script
      type="application/ld+json"
      dangerouslySetInnerHTML={{
        __html: JSON.stringify(jsonLd).replace(/</g, "\\u003c"),
      }}
    />
  );
}
Terakhir, dua file yang jadi penunjuk jalan buat crawler, dua-duanya dibikin lewat kode di Next.js:
// app/robots.ts
import type { MetadataRoute } from "next";

export default function robots(): MetadataRoute.Robots {
  return {
    rules: { userAgent: "*", allow: "/" },
    sitemap: "https://example.com/sitemap.xml",
  };
}

// app/sitemap.ts
export default async function sitemap(): Promise<MetadataRoute.Sitemap> {
  const posts = await getAllPosts();
  return [
    { url: "https://example.com", lastModified: new Date() },
    ...posts.map((p) => ({
      url: `https://example.com/articles/${p.slug}`,
      lastModified: p.updatedAt ?? p.publishedAt,
    })),
  ];
}
FIG. 05Use Case: Link yang Keliatan Mati Suri
Skenario yang sering banget kejadian: kamu rilis proyek portfolio terus dishare di LinkedIn. Postingannya banyak yang liat, tapi yang klik hampir nol. Previewnya cuma kotak abu-abu plus URL mentah.
Diagnosisnya selalu tiga pengecekan yang sama. Ada og:image dengan URL absolut gak? og:title udah diatur, atau platform masih pakai <title> generik sebagai cadangan? Previewnya udah keburu ke-cache sebelum kamu nambah tag? Solusinya: tambahin tag-nya, terus paksa scrape ulang. Kontennya gak berubah; halamannya aja yang akhirnya mulai kenalan.
FIG. 06Use Case: Dua URL, Satu Halaman
Kamu deploy blog, terus baru sadar artikel yang sama bisa dibuka di /articles/post, /articles/post/, dan /articles/post?utm_source=newsletter. Search engine liat tiga kandidat dan harus milih, sementara sinyal peringkat kayak backlink jadi kebagi-bagi ke ketiganya.
Canonical per halaman (alternates.canonical di generateMetadata) nunjuk ketiganya ke satu alamat. Ditambah sitemap yang isinya cuma URL canonical, kamu udah ngasih tau semua crawler dengan jelas versi mana yang dihitung.
FIG. 07Checklist Audit Kilat
Cek daftar ini di halaman mana pun sebelum rilis:
| Cek | Kenapa penting |
|---|---|
<title> unik per halaman | Judul hasil pencarian dan nama tab |
| Meta description, ~150 karakter | Cuplikan yang bikin orang klik |
| Canonical diatur per halaman, bukan di layout | Biar gak kena dilusi gara-gara URL duplikat |
og:image absolut, ~1200×630 | Preview link yang bisa diandalkan |
robots.txt gak ngeblokir halaman yang mau kamu noindex | Crawling vs. pengindeksan |
| Sitemap isinya cuma URL canonical | Penemuan yang lebih cepat dan rapi |
| JSON-LD valid | Peluang dapet rich result |
| Preview di-scrape ulang abis ada perubahan | Platform nge-cache dengan rajin |
Metadata itu kerjaan paling murah di dunia web dev dengan efek paling panjang. Ditulis sekali, dan tiap crawler, platform, sama hasil pencarian bakal baca selamanya.
FIG. 08Bacaan Lanjutan
Semua sumber di bawah pakai bahasa Inggris ya.