Catatan Lapangan
Metadata 101: Beri Tahu Web Apa Sebenarnya Situsmu
Kamu bisa merilis website yang cepat dan indah, tetapi tetap tidak terlihat. Hasil pencarian menampilkan cuplikan kosong, tautan yang dibagikan muncul sebagai URL polos tanpa gambar, dan crawler mengindeks versi halaman yang salah. Semua itu bukan masalah desain. Itu masalah metadata.
Belum lama ini aku memposting carousel singkat tentang topik ini di LinkedIn. Artikel ini adalah versi panjangnya: apa fungsi tiap metadata, siapa yang membacanya, dan bagaimana mengimplementasikannya dengan benar di proyek Next.js App Router.
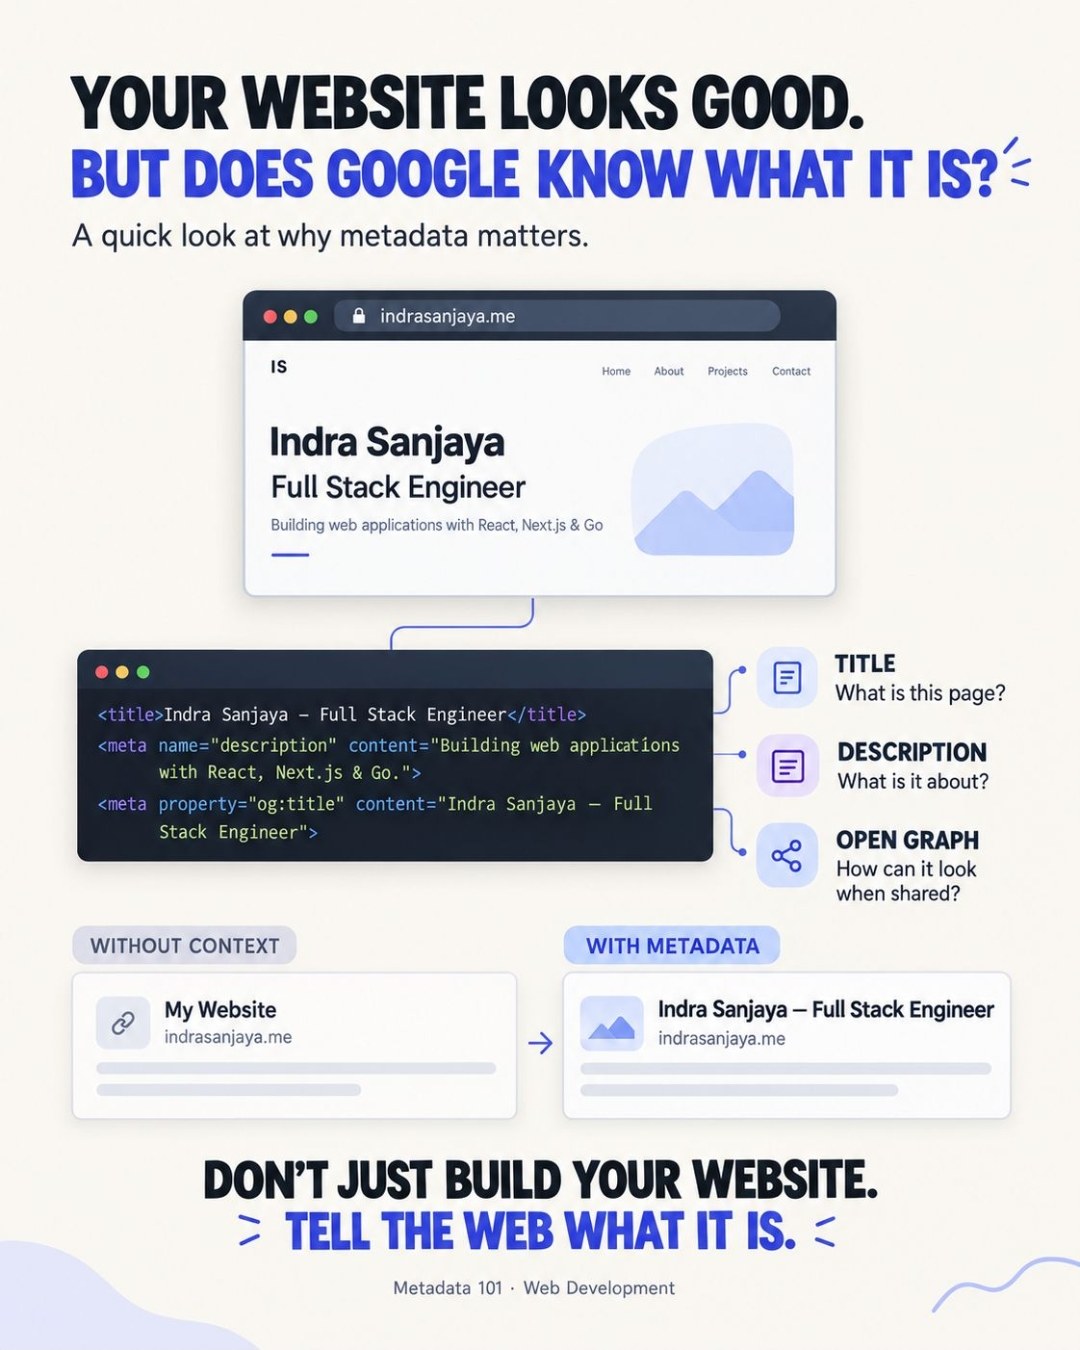
FIG. 01Satu Halaman, Tiga Pembaca
Halamanmu dibaca oleh tiga audiens yang sangat berbeda, dan hanya satu di antaranya yang punya mata.
- Manusia membaca tampilan yang dirender: layout, teks, gambar.
- Search engine membaca HTML untuk menentukan halaman ini tentang apa, apakah isinya duplikat, dan apa yang ditampilkan sebagai hasil pencarian.
- Crawler dan platform (LinkedIn, Slack, X, WhatsApp, Discord) mengambil halamanmu untuk membuat preview tautan, dan umumnya tidak menjalankan JavaScript-mu.
Metadata adalah bagian halaman yang ditulis untuk audiens kedua dan ketiga. Ia berada di <head>, tidak terlihat oleh pengunjung, dan menjadi satu-satunya cara untuk memberi tahu mesin halaman ini apa secara sengaja, alih-alih membiarkan mereka menebak.
Kalau kamu tidak menjelaskan halamanmu kepada mesin, mereka akan menjelaskannya sendiri, dan hasilnya jarang menyenangkan.
FIG. 02Di Mana Tiap Sinyal Bekerja
"Metadata" bukan satu mekanisme tunggal. Sinyal yang berbeda bekerja di tahap yang berbeda dalam perjalanan sebuah halaman, dan mencampuradukkannya adalah sumber kesalahan paling umum.
Sebuah halaman ditemukan (sitemap, tautan), di-crawl (diambil, tunduk pada robots.txt), diindeks (dipahami dan disimpan), lalu akhirnya ditampilkan (sebagai hasil pencarian atau preview tautan). Satu hal yang layak dihafal: robots.txt mengatur crawling, bukan pengindeksan. Kalau kamu memblokir sebuah halaman di sana, crawler tidak akan pernah melihat tag noindex-nya, dan URL itu tetap bisa muncul di hasil pencarian. Untuk menjauhkan halaman dari indeks, izinkan crawling dan gunakan noindex.
FIG. 03Lima Hal Esensial
Title dan meta description
<title> adalah judul hasil pencarianmu sekaligus label tab browser. Buat spesifik dan cukup pendek agar tidak terpotong, kira-kira 50 sampai 60 karakter. Meta description adalah pitch-mu di bawahnya. Ia tidak memengaruhi peringkat secara langsung, dan search engine boleh menulis ulang keduanya, tetapi deskripsi yang jelas adalah yang membuat orang mengklik.
Google juga mengabaikan tag lama meta keywords. Lewati saja.
Canonical URL
Konten yang sama sering hidup di beberapa alamat: dengan dan tanpa www, dengan parameter pelacakan, dengan atau tanpa garis miring di akhir. Canonical URL memberi tahu search engine mana yang menjadi versi utama, sehingga sinyalnya terkonsolidasi, bukan terpecah. Ini adalah petunjuk, bukan perintah, dan harus diatur per halaman. Canonical yang diatur sekali di layout bersama akan mengarahkan setiap halaman ke URL yang sama, dan itu lebih buruk daripada tidak punya canonical sama sekali.
Open Graph dan Twitter Cards
Tag Open Graph (og:title, og:description, og:image, og:url) mengatur apa yang ditampilkan platform ketika tautanmu dibagikan. Gunakan URL gambar absolut dengan ukuran sekitar 1200×630. Platform menyimpan cache preview dengan agresif, jadi setelah mengubah tag, scrape ulang URL-nya lewat debugger milik platform (LinkedIn Post Inspector, Facebook Sharing Debugger).
Structured data
Structured data, idealnya dalam bentuk JSON-LD, menjelaskan entitas secara eksplisit: halaman ini adalah sebuah Article, ditulis oleh Person ini, terbit pada tanggal ini. Ia membantu search engine menafsirkan halaman dan dapat membuatnya memenuhi syarat untuk rich result, meskipun tidak menjamin apa pun.
FIG. 04Implementasi di Next.js
App Router punya Metadata API kelas satu, jadi semua ini tidak perlu tag <head> yang ditulis manual. Mulailah dari default seluruh situs di root layout:
import type { Metadata } from "next";

export const metadata: Metadata = {
  metadataBase: new URL("https://example.com"),
  title: {
    default: "Your Name — Software Engineer",
    template: "%s | Your Name",
  },
  description: "One clear sentence about who you are and what you build.",
  openGraph: {
    type: "website",
    siteName: "Your Name",
    images: ["/og-image.png"],
  },
  twitter: { card: "summary_large_image" },
};
metadataBase memungkinkan kamu memakai path relatif di tempat lain; Next.js mengubahnya menjadi URL absolut, yang dibutuhkan crawler sosial. Lalu timpa per halaman dengan generateMetadata, termasuk canonical-nya:
import type { Metadata } from "next";

export async function generateMetadata({
  params,
}: {
  params: Promise<{ slug: string }>;
}): Promise<Metadata> {
  const { slug } = await params;
  const post = await getPost(slug);

  return {
    title: post.title,
    description: post.description,
    alternates: { canonical: `/articles/${slug}` },
    openGraph: {
      type: "article",
      title: post.title,
      description: post.description,
      publishedTime: post.publishedAt,
      images: [post.ogImage ?? "/og-image.png"],
    },
  };
}
Satu jebakan: field metadata bersarang digabung secara dangkal (shallow). Kalau sebuah halaman mendefinisikan openGraph, seluruh objek openGraph dari layout akan tergantikan, jadi tulis ulang field (seperti siteName) yang masih kamu inginkan.
Tambahkan structured data sebagai script JSON-LD, dengan < di-escape agar konten tidak bisa keluar dari tag:
const jsonLd = {
  "@context": "https://schema.org",
  "@type": "Article",
  headline: post.title,
  description: post.description,
  datePublished: post.publishedAt,
  author: { "@type": "Person", name: "Your Name" },
};

export default function Page() {
  return (
    <script
      type="application/ld+json"
      dangerouslySetInnerHTML={{
        __html: JSON.stringify(jsonLd).replace(/</g, "\\u003c"),
      }}
    />
  );
}
Terakhir, dua file yang memandu crawler, keduanya dihasilkan lewat kode di Next.js:
// app/robots.ts
import type { MetadataRoute } from "next";

export default function robots(): MetadataRoute.Robots {
  return {
    rules: { userAgent: "*", allow: "/" },
    sitemap: "https://example.com/sitemap.xml",
  };
}

// app/sitemap.ts
export default async function sitemap(): Promise<MetadataRoute.Sitemap> {
  const posts = await getAllPosts();
  return [
    { url: "https://example.com", lastModified: new Date() },
    ...posts.map((p) => ({
      url: `https://example.com/articles/${p.slug}`,
      lastModified: p.updatedAt ?? p.publishedAt,
    })),
  ];
}
FIG. 05Use Case: Tautan yang Tampak Mati
Skenario yang umum: kamu merilis proyek portfolio lalu membagikannya di LinkedIn. Postingannya dilihat banyak orang, tetapi hampir tidak ada yang mengklik. Previewnya hanya kotak abu-abu dengan URL mentah.
Diagnosisnya selalu tiga pemeriksaan yang sama. Apakah ada og:image dengan URL absolut? Apakah og:title sudah diatur, atau platform memakai <title> generik sebagai cadangan? Apakah preview sudah ter-cache sebelum kamu menambahkan tag? Solusinya: tambahkan tag, lalu paksa scrape ulang. Kontennya tidak berubah; halamannya hanya mulai memperkenalkan dirinya.
FIG. 06Use Case: Dua URL, Satu Halaman
Kamu men-deploy blog dan baru sadar artikel yang sama bisa diakses di /articles/post, /articles/post/, dan /articles/post?utm_source=newsletter. Search engine melihat tiga kandidat dan harus memilih, sementara sinyal peringkat seperti tautan masuk terbagi di antara ketiganya.
Canonical per halaman (alternates.canonical di generateMetadata) mengarahkan ketiganya ke satu alamat. Bersama sitemap yang hanya memuat URL canonical, kamu sudah memberi tahu setiap crawler dengan jelas versi mana yang dihitung.
FIG. 07Checklist Audit Cepat
Jalankan daftar ini pada halaman mana pun sebelum dirilis:
| Pemeriksaan | Mengapa penting |
|---|---|
<title> unik per halaman | Judul hasil pencarian dan label tab |
| Meta description, ~150 karakter | Cuplikan yang mengundang klik |
| Canonical diatur per halaman, bukan di layout | Mencegah dilusi akibat URL duplikat |
og:image absolut, ~1200×630 | Preview tautan yang andal |
robots.txt tidak memblokir halaman yang ingin kamu noindex | Crawling vs. pengindeksan |
| Sitemap hanya memuat URL canonical | Penemuan yang lebih cepat dan bersih |
| JSON-LD valid | Peluang mendapat rich result |
| Preview di-scrape ulang setelah perubahan | Platform menyimpan cache dengan agresif |
Metadata adalah pekerjaan termurah dalam pengembangan web dengan dampak terpanjang. Kamu menulisnya sekali, dan setiap crawler, platform, serta hasil pencarian membacanya selamanya.
FIG. 08Bacaan Lanjutan
Semua sumber di bawah berbahasa Inggris.